发展人工智能芯片,中国不能“偏科”
中国在人工智能芯片领域取得了显著进展,以寒武纪、华为昇腾、地平线等为代表的企业,在专用 AI 加速芯片、云端训练芯片以及边缘推理芯片等方面不断推出新品,人工智能硬件销售也呈现快速增长态势。据相关市场报告显示,中国 AI 芯片市场规模已突破千亿元,年复合增长率保持在 30% 以上,成为全球最具活力的区域市场之一。在欣喜于整体增长的也必须清醒地看到,中国 AI 芯片产业在结构上存在明显的“偏科”现象——过度集中在部分技术路线和应用场景,而在另一些关键环节却存在短板。这种失衡如不加以纠正,将制约产业长期竞争力。
所谓“偏科”,主要体现在以下几个方面。第一,芯片类型偏向专用集成电路(ASIC),而通用图形处理器(GPGPU)和可重构计算等路线相对薄弱。由于深度学习算法一度以卷积神经网络为主,不少国内企业集中于研发固定功能的 ASIC,这类芯片在特定任务上能效比高,但灵活性不足。随着 Transformer 等新架构大模型兴起,算法迭代加速,ASIC 面临很快过时的风险,而灵活的 GPGPU 和可编程芯片才能更好地适应变化。但目前高端 GPGPU 市场仍由英伟达主导,国产通用 GPU 在性能、生态和软件栈成熟度上均有明显差距。
第二,技术节点偏重成熟制程,先进制程受制于人。大量国产 AI 芯片采用 28nm、14nm 甚至更成熟的工艺,固然可以满足部分边缘推理需求,但云端训练芯片对算力和能效的极高要求,使得 7nm、5nm 乃至更先进制程成为刚需,而这恰恰是国内产业受制约的环节。受外部出口管制影响,先进制程代工和高端存储(如 HBM)的获取难度加大,直接影响了国产高端 AI 训练芯片的量产和迭代。
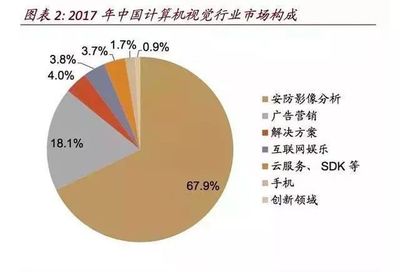
第三,应用场景偏重互联网和安防,而在工业、医疗、自动驾驶、科学计算等领域的渗透不足。当前 AI 芯片销售的大头仍来自互联网公司的数据中心和智慧城市安防项目,工业质检、药物研发、气候模拟等需要高性能计算的领域,国产芯片的落地案例还不多。这种需求端的偏科,反过来又会导致资本和研发资源过度集中于少数赛道,忽略更宽广的蓝海。
第四,产业链生态偏重硬件指标,软件栈和开发者社区建设相对滞后。芯片性能再强,如果没有易用的编程框架、丰富的算子库和活跃的开发者生态,用户迁移成本高企,销售也难以持续放量。英伟达的 CUDA 生态经过十余年积累,已成为事实标准,国产芯片虽然也在推自己的平台(如华为的 CANN、寒武纪的 Neuware),但生态成熟度、兼容性和社区活跃度仍有待提升。
要改变这种“偏科”局面,需要从多处着手。在技术路线上,应鼓励多种架构并行探索,既要继续优化 ASIC,也要大力支持通用 GPU、存算一体、光子计算、类脑芯片等前沿方向,降低单一技术路线依赖的风险。在制造环节,除了推动成熟制程的自主可控,还要通过先进封装、异构集成、Chiplet(芯粒)等方式“绕道”突破性能瓶颈,弥补先进制程暂时受限的短板。在应用端,政府可通过首台套补贴、场景开放等政策,引导 AI 芯片向工业、农业、医疗、交通等领域渗透,让销售结构更加均衡。在生态建设上,需加大基础软件投入,推动高校开设相关课程,培育开发者社区,并主动拥抱开源,参与国际标准制定,降低用户切换门槛。
人工智能硬件销售的增长是好事,但若只集中于某几类芯片或某几个场景,无法支撑中国在 AI 时代的整体竞争力。只有补齐短板,多元并进,做到芯片种类、制程工艺、应用领域和产业生态的均衡发展,中国 AI 芯片产业才能行稳致远,在全球竞争中形成真正稳固的优势。
如若转载,请注明出处:http://www.hhaza.com/product/17.html
更新时间:2026-10-24 19:21:25